2026-11-06 · 11 min read · James Pichardo
Read in English →Visto no es detenido: 30 días de simulaciones de ataque contra cuatro EDR
Durante un mes ejecutamos seis cadenas de ataque basadas en inteligencia de amenazas en endpoints protegidos por cuatro EDR distintos. Casi todos los ataques fueron vistos. Muchos menos fueron detenidos, y ninguna de las razones aparecía en un panel.
TL;DR
- Durante 30 días, Project Achilles ejecutó seis cadenas de ataque de varias etapas, construidas a partir de inteligencia de amenazas publicada, en 27 endpoints Windows de una organización. Cada endpoint tenía uno de cuatro productos EDR en modo activo. Los llamamos EDR A a D.
- Cada EDR generó una alerta en el 81% al 100% de las ejecuciones en sus equipos. La proporción de ataques que realmente detuvo fue del 30% al 90%.
- El EDR que más detuvo lo hizo sobre todo bloqueando los binarios de prueba antes de que se ejecutaran. Es una protección real, pero también significa que nunca vimos cómo maneja las etapas posteriores de un ataque.
- Un EDR, con todos sus agentes en modo "protect", detuvo el 9% de las etapas de ataque que se ejecutaron. Generó alertas en muchas más.
- Tres técnicas superaron a todos los EDR que las enfrentaron: suplantación de binarios (T1036), exfiltración por el canal de comando y control (T1041) y robo de credenciales de almacenes de contraseñas (T1555).
- Cinco diferencias entre EDR parecían estadísticamente sólidas hasta que quitamos una sola prueba. Entonces casi desaparecieron. Una sola foto no es una medición.
Por qué hicimos esto
En Tus defensas se ven en verde. ¿Funcionan? explicamos cómo funciona la validación continua con datos ilustrativos. Este artículo muestra lo que encontró en una flota real durante un mes.
Teníamos un escenario poco común. La organización usa cuatro productos EDR distintos, cada uno activo en un grupo diferente de endpoints Windows. En 13 de los 27 endpoints también funciona un segundo producto EDR en modo pasivo. Durante 30 días, Project Achilles ejecutó las mismas seis cadenas de ataque en todos ellos:
| Cadena de ataque | Qué hace |
|---|---|
| Kothamine Tailcat | Canal cifrado de comando y control y exfiltración de datos |
| LockBit 3.0 | Cadena de ransomware de doble extorsión |
| Qilin (Agenda) | Desactivación del EDR con un driver vulnerable (BYOVD) e inyección en svchost |
| Infostealer tipo Lumma | Robo de credenciales del navegador mediante inyección de procesos |
| The Gentlemen | Intrusión mediante GPO y herramientas del propio sistema (living off the land) |
| Star Blizzard | Cadena de espionaje RedFlick/CosmicPulse |
Eso nos dio 177 ejecuciones analizables, cada una dividida en sus etapas, más todas las alertas que generaron los cuatro EDR en esos equipos durante el período.
No nombramos los productos. Varias licencias de EDR restringen la publicación de resultados comparativos. Y, sobre todo, la mayor parte de lo que encontramos depende de la configuración y del diseño de las pruebas, no de la marca. Toma las letras como cuatro despliegues reales, no como un ranking de productos.
1. Casi todo fue visto. Mucho menos fue detenido.
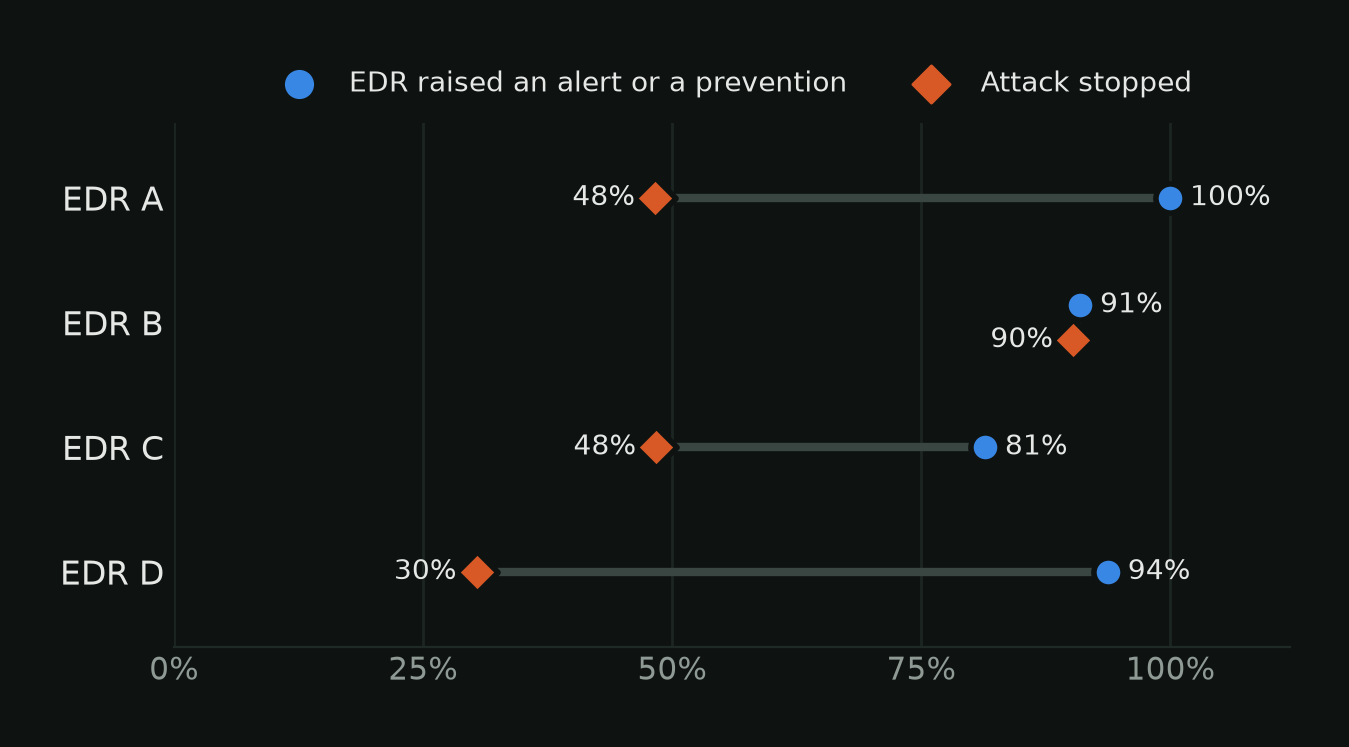
Gráficos en inglés: "EDR raised an alert or a prevention" = el EDR generó una alerta o una prevención; "Attack stopped" = ataque detenido.
Todos los EDR generaron algo en la mayoría de las ejecuciones: entre el 81% y el 100%. Medidos por visibilidad, todos se ven bien. Pero en tres de los cuatro hay una diferencia de 33 a 64 puntos porcentuales entre "generó una alerta" y "detuvo el ataque".
Esa diferencia no es una falla del panel. El panel hace lo que fue diseñado para hacer: muestra que el sensor funciona y genera alertas. No muestra si el ataque se completó, y un ataque en el que cada etapa genera una alerta igual puede llegar a su objetivo. Una detección solo sirve si alguien actúa a tiempo.
2. Dónde un EDR detiene un ataque decide qué puedes aprender
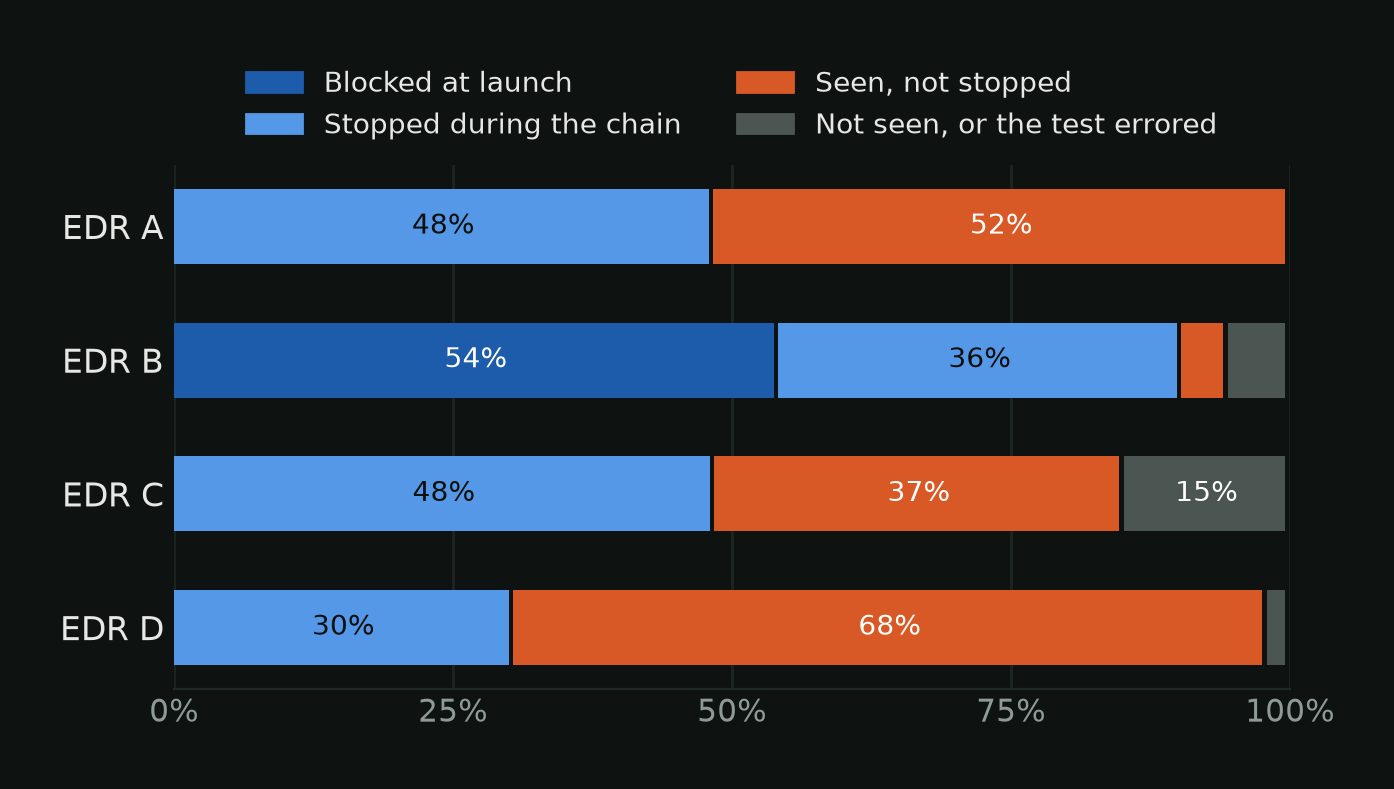
"Blocked at launch" = bloqueado al inicio; "Stopped during the chain" = detenido durante la cadena; "Seen, not stopped" = visto, no detenido; "Not seen, or the test errored" = no visto, o la prueba falló.
EDR B detuvo el 90% de los ataques, con diferencia el que más. Más de la mitad de esas detenciones vinieron de bloquear el binario de prueba al inicio, antes de que se ejecutara ninguna técnica. Es protección genuina: los atacantes también usan binarios nuevos, y negarse a ejecutarlos es una defensa fuerte.
También tiene un efecto secundario. En tres de las seis cadenas, los equipos de EDR B no produjeron ningún resultado de etapa utilizable. Sabemos que EDR B bloquea esos binarios. No sabemos cómo manejaría las etapas en memoria y con herramientas del sistema si un binario sí llegara a ejecutarse, por ejemplo uno entregado de una forma que sus controles de inicio no cubren. En las tres cadenas donde sí se ejecutaron etapas, EDR B detuvo o detectó el 54%.
La manera de cubrir ese hueco es una variante de la prueba que el EDR no detenga al inicio, como una cadena lanzada desde un script o una herramienta integrada de Windows, dejando la política de producción exactamente como está. Nunca debilites una protección para poder medirla.
3. El modo "protect" no es una garantía
Todos los agentes de EDR D reportaban estar en modo protect. Aun así, EDR D detuvo solo el 30% de los ataques y el 9% de las etapas que se ejecutaron. En el 68% de sus ejecuciones generó alertas y dejó que la cadena continuara.
Una causa probable: los EDR modernos tienen varios motores de detección (reglas de comportamiento, reglas personalizadas, analítica en la nube), y cada motor tiene su propia configuración de respuesta. El agente puede estar en modo protect mientras los motores que realmente se activaron están configurados solo para alertar. Revísalo motor por motor, no agente por agente.
EDR A muestra otro patrón. Detectó todas las ejecuciones y detuvo el 48%, pero de forma todo o nada según la cadena de ataque. Detuvo todas las ejecuciones de Kothamine y ninguna de Lumma, The Gentlemen o Star Blizzard, aunque generó alertas en todas. Su política bloquea algunos comportamientos y solo reporta otros.
4. El tiempo de alerta no es el tiempo de bloqueo
Mediana del tiempo entre el inicio de una ejecución y la primera alerta del EDR:
| EDR | Mediana hasta la primera alerta | Ejecuciones con alerta |
|---|---|---|
| EDR A | 24 s | 30 |
| EDR B | 64 s | 41 |
| EDR D | 73 s | 34 |
| EDR C | 2,3 min | 46 |
Estas cifras miden qué tan rápido llega la alerta a la consola, no qué tan rápido se bloqueó el ataque. EDR B bloquea binarios al inicio, en el primer segundo, y aun así sus alertas por esos bloqueos aparecieron cerca de un minuto después. Para tu SOC lo que importa es el tiempo de alerta: es cuánto tarda alguien en poder responder. Para el ataque, lo que importa es el tiempo de bloqueo. Mídelos por separado, y desconfía de cualquier cifra de un fabricante que no diga cuál de los dos es.
Una cosa más que vale la pena medir: la técnica ATT&CK de la alerta coincidió con la técnica que la prueba realmente ejecutó solo en el 14% al 49% de las alertas, según el EDR. Si tu SOC clasifica o reporta por técnica ATT&CK, está trabajando con etiquetas que a menudo están mal.
5. Un segundo sensor ayuda a unos grupos y a otros no
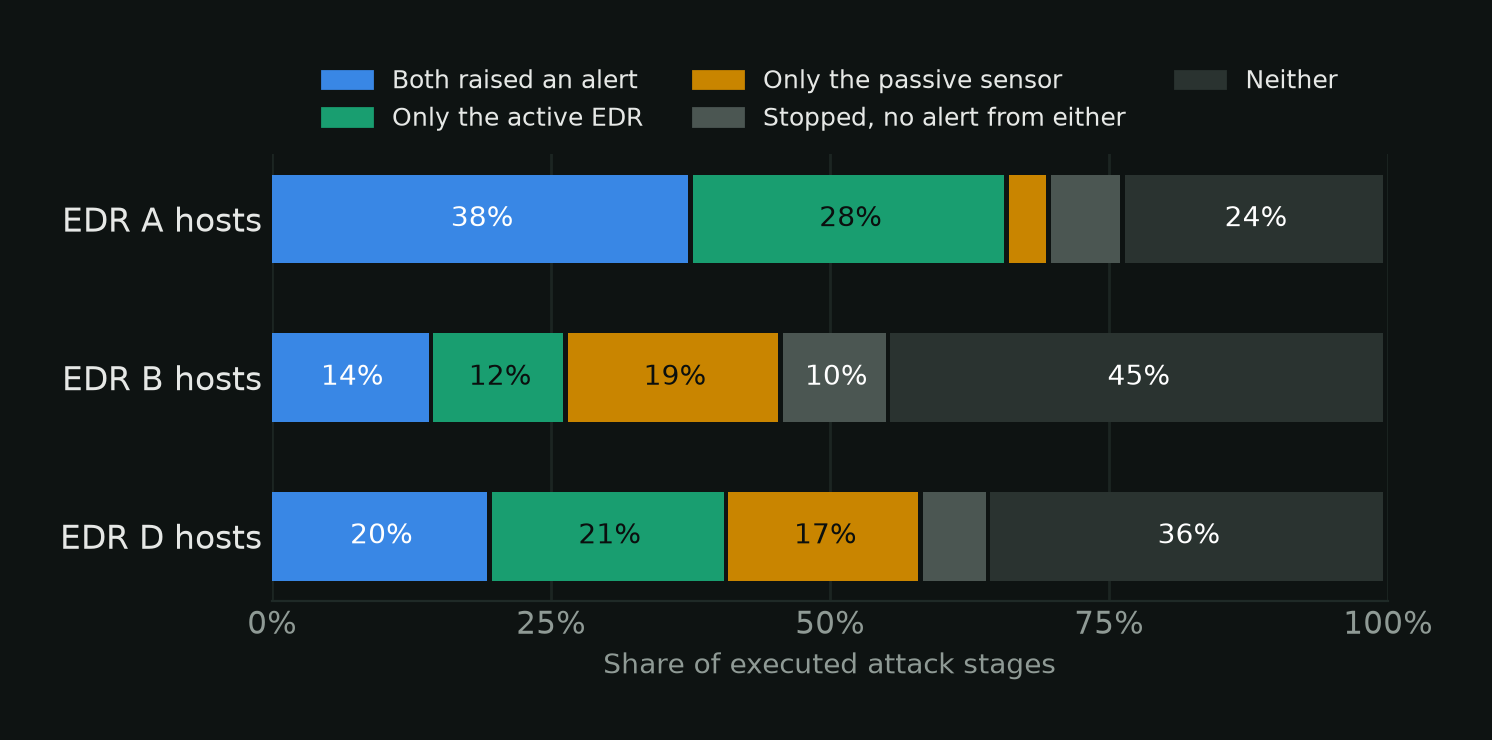
"Both raised an alert" = ambos generaron alerta; "Only the active EDR" = solo el EDR activo; "Only the passive sensor" = solo el sensor pasivo; "Stopped, no alert from either" = detenida, sin alerta de ninguno; "Neither" = ninguno.
En 13 equipos, un segundo producto EDR funcionaba en modo pasivo junto al activo, así que ambos observaron exactamente los mismos ataques. Lo que aportó el segundo sensor dependió por completo de su compañero:
- En los equipos de EDR B, el sensor pasivo generó alertas en 16 etapas que EDR B no alertó, frente a 10 al revés.
- En los de EDR D, quedaron casi parejos: 23 frente a 28.
- En los de EDR A, casi no aportó nada: 4 frente a 30.
Algunas de esas etapas pudieron haber sido detenidas por el EDR activo sin generar alerta, así que esto mide visibilidad, no protección. Aun así responde con datos, no con opiniones, una pregunta frecuente de licenciamiento: un segundo sensor vale lo que aporta en tus equipos, junto a tu EDR principal, y eso se puede medir.
6. Tres técnicas que nadie detectó
Tres técnicas pasaron sin detección en al menos el 80% de sus etapas frente a todos los EDR que las enfrentaron:
- T1036, Masquerading: binarios disfrazados de programas legítimos.
- T1041, Exfiltración por el canal C2: datos robados que salen por la propia conexión del atacante.
- T1555, Credenciales de almacenes de contraseñas: recolección de credenciales guardadas.
No son razones para elegir un EDR sobre otro, porque ninguno las detectó. Son un backlog de ingeniería de detección: reglas propias, monitoreo de red para datos que salen por el canal C2 y endurecimiento de los almacenes de credenciales. Un backlog así solo se descubre ejecutando las técnicas.
¿Qué tan seguros podemos estar?
Con 4 a 14 equipos por EDR, es fácil ver un patrón que no existe. Usamos el equipo, no la ejecución, como unidad de análisis, y le pusimos a cada comparación una etiqueta de confianza basada en un bootstrap sobre los equipos. Una diferencia se etiqueta como clara solo si se cumple todo esto:
- el intervalo del 95% excluye el cero,
- cada EDR tiene al menos tres equipos,
- la diferencia se mantiene al quitar cualquier equipo,
- la diferencia se mantiene al quitar cualquier cadena de ataque,
- la comparación se apoya en al menos tres cadenas de ataque que ambos EDR enfrentaron.
Lo que se sostuvo. EDR B detuvo entre 42 y 60 puntos porcentuales más ataques que cada uno de los otros tres. Esa diferencia es clara y sobrevive a quitar cualquier equipo o cualquier prueba. EDR A y EDR C detuvieron la misma proporción de ataques (48% cada uno), así que ahí no hay ganador.
Lo que no. Cinco diferencias pasaron todas las comprobaciones excepto la última:
| Diferencia | Brecha | Sin esa prueba |
|---|---|---|
| EDR C detiene más ataques que EDR D | +18 pp | +6 pp sin Lumma |
| EDR A detiene más ataques que EDR D | +18 pp | +2 pp sin Kothamine |
| EDR A detiene más etapas que EDR D | +22 pp | +3 pp sin Kothamine |
| EDR C ve más etapas que EDR B | +14 pp | +1 pp sin LockBit |
| EDR A ve más etapas que EDR C | +12 pp | +2 pp sin Kothamine |
Cada una es real, pero habla de una cadena de ataque, no del EDR en general. "EDR A ve más que EDR C" en realidad significa "EDR A manejó Kothamine mucho mejor", que es algo más concreto y más útil para actuar.
Otros tres efectos hacen poco confiables las mediciones aisladas:
- La misma prueba en el mismo equipo no siempre da el mismo resultado. Entre ejecuciones repetidas, el resultado fue idéntico solo del 50% al 75% de las veces, según el EDR. Una sola ejecución dice poco.
- Los binarios de prueba cambian. Las cadenas de ataque se recompilaron durante el mes, y no todos los EDR vieron todas las versiones. Si recalculamos solo con la versión que vieron todos los EDR (cinco de las seis cadenas), las tasas de detención son 58% para A, 90% para B, 57% para C y 38% para D. EDR B sigue a la cabeza, pero por menos.
- Las integraciones empiezan en momentos distintos. Los datos de alertas de un EDR solo cubrían los últimos ocho días del período, así que sus ejecuciones anteriores se dejaron fuera en lugar de contarse como fallos.
Qué significa para tu entorno
Ninguno de estos hallazgos aparece en la consola de un EDR, y la mayoría tampoco aparecería en una prueba de penetración anual: una ejecución, con una sola versión, en unos pocos equipos, no puede distinguir "este EDR es mejor" de "a este EDR le fue mejor en esta prueba". Ese es el argumento práctico a favor de la validación continua:
- Mide lo detenido por separado de lo visto. Una alerta en cada etapa de un ataque que se completó no es protección.
- Revisa la configuración de respuesta de cada motor de detección, no solo la del agente.
- Mide la latencia de las alertas por separado del tiempo de bloqueo.
- Ejecuta las técnicas que nadie bloquea y convierte los fallos en reglas de detección.
- Repite en varios equipos y a lo largo del tiempo antes de decidir nada, y acompaña cada comparación con una etiqueta de confianza.
- Si pagas por un segundo sensor, mide lo que aporta en cada grupo de equipos.
Todas las cifras de este artículo salen de datos que Project Achilles ya recolecta: ejecuciones de pruebas, resultados por etapa y las alertas de EDR que correlaciona con ellas. Para medir tu propio entorno, Instala Project Achilles en 30 minutos te guía desde cero, y el explicador interactivo muestra el ciclo en movimiento.